
Ataskaita CC-BY-4.0
lithuanian-dialect-asr-study-2026-10-05.pdf
Galutinė ataskaita, 20 puslapių, su visomis lentelėmis, diagramomis ir visų rezultatų priedu.
/assets/research/lithuanian-dialect-asr-study-2026-10-05.pdfŠis tyrimas – kontroliuojamas Digisensus mokymo eksperimentas, tikrinantis, ar tarminių įrašų pridėjimas pagerina lietuvių šnekos atpažinimą ir ar tarminės transkripcijos turėtų būti tarminės, ar bendrinės rašybos. Jį sudaro 18 mokymo paleidimų su LIEPA-3 tekstynu, iš anksto užregistruotas protokolas, nepriklausomas klientų aptarnavimo testas, o kodas, duomenys ir modeliai paskelbti viešai.
Saulius Jarašiūnas · Tyrimo vadovas, Digisensus, Vilnius
Įmonių pokalbių analitika priklauso nuo tikslaus šnekos atpažinimo, įskaitant atvejus, kai kalbėtojai vartoja regionines tarmes. Tikriname, ar tarminės šnekos pridėjimas pagerina lietuvių šnekos atpažinimą ir ar tarminės transkripcijos turėtų būti tarminės, ar bendrinės rašybos.
Parakeet-TDT modelį papildomai mokome 420,17 val. lietuviškos telefoninės šnekos, pridėdami iki 82,30 val. tarminių įrašų. Lyginame tai su kitos spontaninės šnekos pridėjimu ir tikriname tarminę bei bendrinę transkripcijų rašybą. Mokymo nustatymai fiksuoti. Tarmių atpažinimą vertiname pagal abi rašybas ir pagal „bet kurios formos“ įvertį, kuris priima bet kurią nuorodos formą. Atskiras 2,78 val. klientų aptarnavimo šnekos testas apima anksčiau nematytus kalbėtojus.
Tarminės šnekos pridėjimas sumažina žodžių klaidų dažnį (WER) pagal tarmines nuorodas nuo 41,62 % iki 31,30 %, vidurkinant dviejų mokymo paleidimų rezultatus. Kitos spontaninės šnekos pridėjimas sumažina jį tik iki 40,04 %. Vieno paleidimo palyginime pirmos 25,43 val. duoda apie du trečdalius tarmių testo pagerėjimo. Bendrinės rašybos tarminės transkripcijos duoda mažiausią WER priimant bet kurią formą tarp modelių, taip pat mokytų telefonine šneka: 25,97 %.
Klientų aptarnavimo šnekoje tarminių įrašų pridėjimas sumažina WER kiekviename iš dviejų mokymo paleidimų: vidutiniškai nuo 44,89 % iki 39,43 % su tarmine rašyba ir iki 39,06 % su bendrine rašyba; svyravimas tarp paleidimų šiame teste didesnis nei tarmių teste. WER LIEPA-3 telefoniniame teste keičiasi mažai; tame teste gali būti tų pačių kalbėtojų kaip ir mokyme. Šie rezultatai palaiko tarminių įrašų pridėjimą regioninei šnekai ir klientų aptarnavimo pokalbiams. Transkripcijų rašyba veikia ir išmokstamą išvestį, ir išmatuojamą tikslumą.
| Papildomi mokymo duomenys | Tarmių testas: tarminė rašyba | Tarmių testas: bendrinė rašyba | Tarmių testas: bet kuri forma | LIEPA-3 telefoninė | Klientų aptarnavimo šneka |
|---|---|---|---|---|---|
| Nieko (tik telefoninė šneka) | 41,62 | 35,82 | 34,22 | 10,61 | 44,89 |
| 82,36 val. kitos spontaninės šnekos | 40,04 | 34,10 | 32,40 | 10,34 | 41,66 |
| 82,30 val. tarminės šnekos, tarminės rašybos transkripcijos | 31,30 | 36,73 | 27,82 | 10,76 | 39,43 |
| 82,30 val. tarminės šnekos, bendrinės rašybos transkripcijos | 37,48 | 26,94 | 25,97 | 10,56 | 39,06 |
Digisensus teikia pokalbių analitiką įmonėms. Šis darbas priklauso nuo tikslios telefoninių pokalbių transkripcijos, įskaitant žmonių, vartojančių regionines tarmes, šneką. Šnekos atpažinimą gali apsunkinti ir įrašo kokybė, ir regioninis tarimas. Šis tyrimas skirtas regioninei šnekai: ar tarminiai įrašai pagerina atpažinimą ir kaip turėtų būti rašomos jų transkripcijos. Skambinantieji gali išlaikyti regioninio tarimo bruožus net kalbėdami daugiausia bendrine lietuvių kalba ar gyvendami ne savo kilmės regione. Todėl taip pat tikriname, ar tarminis mokymas padeda nepriklausomuose klientų aptarnavimo įrašuose. Šiais rezultatais dalijamės, kad padėtume kitiems, kuriantiems šnekos atpažinimą kalboms su ribotais mokymo ištekliais.
Lietuvių kalba yra tinkama terpė šiam klausimui. Jos regioninės atmainos nuo bendrinės kalbos skiriasi tarimu ir kaityba. Todėl tarminį įrašą galima transkribuoti formomis, atspindinčiomis kalbėtojo tarimą, arba atitinkamomis bendrinės lietuvių kalbos formomis. Šis pasirinkimas veikia ir modelio mokymą, ir jo vertinimą: atpažintuvas gali nustatyti norimą žodį, bet gauti klaidą, nes jo rašyba skiriasi nuo nuorodos transkripcijos.
Tiriame tris praktinius klausimus. Kiek pagerėja atpažinimas, kai prie bendrinės šnekos mokymo duomenų pridedama daugiau tarminės šnekos? Ar tarminė šneka padeda labiau nei toks pat kiekis kitos spontaninės šnekos? Ir ar tarminės mokymo transkripcijos turėtų būti tarminės, ar bendrinės rašybos? Taip pat matuojame pokyčius bendrinėje lietuviškoje telefoninėje šnekoje, tiriame perkėlimą į regionus, kurių nėra tarminiame mokyme, ir lyginame atidėtus mokymo kalbėtojų įrašus su nematytų kalbėtojų įrašais.
Kad atskirtume dviejų rašybų poveikį, tas pačias modelių išvestis vertiname pagal suporuotas tarmines ir bendrines transkripcijas. Taip pat naudojame „bet kurios formos“ žodžių klaidų dažnį, priimantį bet kurią kiekvieno žodžio nuorodos rašybą. Pavyzdys žemiau rodo, kodėl šie įverčiai gali skirtis. Kartu trys įverčiai parodo, kiek išmatuotas rezultatas priklauso nuo vertinant priimamos rašybos.
| Modelio išvestis tam pačiam ištartam žodžiui | Tarminė nuoroda: giveno | Bendrinė nuoroda: gyveno | Priimama bet kuri forma |
|---|---|---|---|
| giveno (tarminė „gyveno“ forma) | Teisinga | Klaida | Teisinga |
| gyveno (bendrinė forma) | Klaida | Teisinga | Teisinga |
| gavo (kitas žodis) | Klaida | Klaida | Klaida |
Ankstesni tyrimai nagrinėjo šnekos atpažinimą skirtingiems akcentams ir tarmėms, įskaitant anglų kalbos akcentus, Egipto arabų ir Šveicarijos vokiečių kalbas. Šie tyrimai sprendžia ir reprezentatyvių įrašų prieinamumo, ir rašytinių transkripcijų pasirinkimo klausimus. Tarmėms be vienos nusistovėjusios rašybos tie patys ištarti žodžiai gali turėti kelias priimtinas rašytines formas.
Esami duomenų rinkiniai renkasi skirtingus kelius. Arabų MGB-3 iššūkis transkribuoja Egipto arabų kalbą taip, kaip tariama, ir leidžia kelias rašybas. Šveicarijos parlamentų tekstynas Šveicarijos vokiečių šneką poruoja su bendrinės vokiečių kalbos tekstu, atpažinimą traktuodamas kaip vertimą tarp artimų kalbos atmainų. Mūsų tyrimas lygina tarminę ir bendrinę rašybą naudodamas tuos pačius lietuviškus įrašus ir mokymo nustatymus. Suporuotos nuorodų transkripcijos leidžia kiekvieną modelį įvertinti pagal abi rašybos konvencijas ir pagal įvertį, priimantį bet kurią formą.
LIEPA-3 – atvirai prieinamas 10 000 valandų anotuotos lietuvių šnekos tekstynas, sukurtas Europos Sąjungos lėšomis per NextGenerationEU / „Naujos kartos Lietuva“ šnekos atpažinimui ir tyrimams. Jame yra skaitomos šnekos, spontaninės šnekos ir 100 valandų tarminių įrašų; jį skelbia Vilniaus universitetas, Vytauto Didžiojo universitetas ir Lietuvių kalbos institutas pagal CC BY 4.0 licenciją.
Naudojame tris LIEPA-3 dalis: bendrinius telefoninius pokalbius, keturių regionų tarminius įrašus ir kitą spontaninę šneką iš radijo ir diktofono įrašų. Telefoninė šneka yra pagrindiniai mokymo duomenys. Tarminiai įrašai leidžia patikrinti regioninės šnekos pridėjimo vertę, o kiti spontaniniai įrašai suteikia palyginimą pridedant panašų duomenų kiekį. Modelius taip pat vertiname dviem viešais lietuvių skaitomos šnekos rinkiniais – FLEURS ir Common Voice. Papildomai testuojame privačia klientų aptarnavimo šneka.
| Duomenys | Valandos | Paskirtis |
|---|---|---|
| Telefoninė šneka: mokymas | 420,17 | Mokyti bendrinės šnekos atskaitos modelį |
| Tarminė šneka: mokymas | 82,30 | Tikrinti tarminius duomenis ir rašybos pasirinkimus; 97 kalbėtojai |
| Kita spontaninė šneka: mokymas | 82,36 | Palyginti su panašaus kiekio kitos šnekos pridėjimu |
| Tarminė šneka: pagrindinis testas | 5,01 | Tikrinti tarmių atpažinimą su 12 nematytų kalbėtojų |
| Telefoninė šneka: testas | 4,36 | Matuoti pokyčius bendrinėje telefoninėje šnekoje |
| Klientų aptarnavimo šneka: testas | 2,78 | Nepriklausomas privatus testas su anksčiau nematytais kalbėtojais |
| FLEURS: testas | 2,97 | Papildomas vertinimas skaitoma šneka |
| Common Voice 19.0: testas | 7,15 | Papildomas vertinimas skaitoma šneka |
Tarminiai įrašai apima Aukštaitiją, Dzūkiją, Suvalkiją ir Žemaitiją. Pagrindiniame teste yra po tris kalbėtojus iš kiekvieno regiono, parinktus subalansuojant lytį ir amžiaus grupes. Nė vienas iš šių kalbėtojų nepatenka į mokymą.
Dar 8 kalbėtojai suteikia 2,67 val. kūrimo įrašų, naudojamų mokymui stebėti. Jų įrašai taip pat neįtraukiami į mokymą. Visi likę testo ir kūrimo kalbėtojų įrašai, 9,50 val., nenaudojami.
Atskiras 1,01 val. testas apima įrašus, atidėtus iš 12 tarminio mokymo kalbėtojų. Tai leidžia palyginti naujus tų kalbėtojų įrašus su nematytų kalbėtojų įrašais. Patys atidėti įrašai mokymui niekada nenaudojami. Modeliai, mokyti mažesniais tarminiais poaibiais arba be vieno regiono, galėjo matyti tik dalį šių kalbėtojų.
Norėdami ištirti, kaip pagerėjimas priklauso nuo duomenų kiekio, sudarome vis didesnius tarminius mokymo rinkinius. Kiekvienas didesnis rinkinys apima mažesnįjį ir prideda kalbėtojų. Saugykloje užfiksuoti techniniai padalijimų identifikatoriai ir sudarymo taisyklės.
| Tarminis mokymo rinkinys | Valandos | Kalbėtojai |
|---|---|---|
| Mažiausias poaibis | 12,83 | 16 |
| Antras poaibis | 25,43 | 31 |
| Trečias poaibis | 50,47 | 61 |
| Visas mokymo rinkinys | 82,30 | 97 |
Originalios tarminės transkripcijos žodžius užrašo taip, kaip jie tariami. Sukuriame antrą versiją su atitinkamomis bendrinės lietuvių kalbos formomis. Standartizavimo gairės siekia išlaikyti žodžių tvarką, gramatinę reikšmę ir žodžių pasirinkimą; tarminiai žodžiai be bendrinio atitikmens lieka nepakeisti.
Abi versijos sulygiuotos pažodžiui, todėl tą pačią modelio išvestį galima vertinti pagal bet kurią rašybą. Standartizuojant naudojama kalbos modelio pagalba, rašytinės gairės ir automatiniai sulygiavimo patikrinimai. Paruošimo ir peržiūros procedūra dokumentuota saugykloje. Taip pat žymime skirtumus tarp suporuotų žodžių, pavyzdžiui, galūnių ar tarimo pokyčius, kad ištirtume, kurių tipų žodžius vis dar sunku atpažinti.
| Žodžių klasė | Reikšmė | Pavyzdys: tarminė → bendrinė |
|---|---|---|
| Nepakitęs | Ta pati žodžio forma abiejose rašybose | – |
| Galūnės pokytis | Skiriasi tik galūnė | būdava → būdavo; seseris → seserys |
| Raidės ą, ę, į, ų | Tarminėje formoje vietoj šių raidžių rašoma a, e, i, u | viska → viską; mūsu → mūsų |
| Kitas tarimo pokytis | Kitas garso pokytis kamiene | giveno → gyveno; teip → taip |
| Tik tarminis žodis | Nėra bendrinio atitikmens; paliekamas nepakeistas | rozu; bajino |
Telefoniniai duomenys atitinka paskelbtą šiame tyrime naudojamo rinkinio mokymo ir testo padalijimą. Kalbėtojų tapatybės neprieinamos, todėl abiejuose rinkiniuose gali būti tų pačių skambinančiųjų įrašų. Pašaliname mokymo įrašus, kurių šešių ar daugiau žodžių transkripcijos kartoja testo ar kūrimo transkripciją. Todėl telefoniniai rezultatai apibūdina veikimą būtent šioje įrašų kolekcijoje; jie nenustato veikimo su visiškai nematytais skambinančiaisiais.
Palyginimo rinkinyje yra kita spontaninė šneka, daugiausia iš radijo ir diktofono įrašų. Jo trukmė, lyčių pasiskirstymas, amžiaus grupės ir įrašų ilgiai apytiksliai suderinti su tarminiais mokymo duomenimis. Šis palyginimas padeda įvertinti, ar tarminiai įrašai duoda daugiau naudos nei tiesiog daugiau šnekos.
Digisensus suteikia 2,78 val. privačios klientų aptarnavimo šnekos iš kalbėtojų, kurių nėra mokymo, kūrimo ir ankstesniuose testo rinkiniuose. Esamus modelius vertiname šiais nepriklausomais įrašais, kad patikrintume, ar tarminio mokymo nauda siekia toliau nei LIEPA-3.
FLEURS ir Common Voice tikrina skaitomos šnekos atpažinimą, kuris skiriasi nuo spontaninių telefoninių pokalbių. Šiuos rezultatus pateikiame atskirai; rinkinių detalės užfiksuotos protokole.
Lyginame tik telefonine šneka mokytą atskaitos modelį su modeliais, mokytais iš to paties pradinio kontrolinio taško skirtingais mokymo duomenų deriniais. Keičiame pridedamos šnekos kiekį ir tipą arba jos transkripcijų rašybą. Kiekvienas palyginimas atsako į konkretų klausimą.
| Klausimas | Palyginimas |
|---|---|
| Kaip daugiau tarminės šnekos veikia atpažinimą? | Pridėti vis didesnius tarminius rinkinius: 12,83, 25,43, 50,47, 82,30 val. |
| Ar tarminė šneka padeda labiau nei tiesiog daugiau duomenų? | Palyginti 82,30 val. tarminės šnekos pridėjimą su 82,36 val. kitos spontaninės šnekos. |
| Kuri transkripcijų rašyba veikia geriau? | Mokyti tais pačiais tarminiais įrašais su tarminės arba bendrinės rašybos transkripcijomis. |
| Ar nauda siekia klientų aptarnavimo pokalbius? | Įvertinti visus modelius nepriklausoma klientų aptarnavimo šneka iš anksčiau nematytų kalbėtojų. |
| Ar nauda siekia neatstovaujamą regioną? | Palyginti modelius, mokytus su testuojamo regiono įrašais ir be jų. |
| Ar mokymo kalbėtojus lengviau atpažinti? | Palyginti atidėtus mokymo kalbėtojų įrašus su nematytų kalbėtojų įrašais. |
| Ar būtinas bendrinės telefoninės šnekos mokymas? | Palyginti jungtinį mokymą su mokymu vien tarminiais įrašais. |
Taip pat įvertiname originalius Parakeet-TDT ir Whisper large-v3 modelius be papildomo mokymo, kad turėtume atskaitos taškus mokytiems modeliams.
Visi mokyti modeliai pradedami nuo to paties daugiakalbio Parakeet-TDT kontrolinio taško ir naudoja tuos pačius mokymo nustatymus. Kiekvienas paleidimas mokomas 10 000 atnaujinimų. Vertiname galutinį kontrolinį tašką, o ne renkamės jį pagal kūrimo ar testo rezultatus.
Keturias pagrindines sąlygas kartojame du kartus: vien telefoninė šneka, telefoninė šneka ir kita spontaninė šneka, telefoninė šneka ir visas tarminis rinkinys su kiekviena transkripcijų rašyba. Pakartojimai naudoja skirtingas atsitiktines sėklas, keičiančias, pavyzdžiui, mokymo duomenų tvarką. Kitos sąlygos turi po vieną paleidimą. Fiksuota mokymo procedūra daro palyginimus nuoseklius, nors skirtingiems mokymo rinkiniams geriausiam rezultatui gali reikėti skirtingo mokymo kiekio. Visi mokymo nustatymai užfiksuoti saugykloje.
Žodžių klaidų dažnis (WER) skaičiuoja pakeistus, praleistus ir papildomus žodžius, padalytus iš nuorodos žodžių skaičiaus, išreikštus procentais. Mažiau yra geriau. Skaičiuojame jį per visus kiekvieno testo rinkinio įrašus. Prieš vertinant normalizuojame didžiąsias raides, skyrybą ir tarpus. Tarminei šnekai pateikiame tris atskirus įverčius.
| Įvertis | Kas laikoma teisinga žodžio forma? |
|---|---|
| Tarminės rašybos WER | Forma tarminėje transkripcijoje. |
| Bendrinės rašybos WER | Forma bendrinėje transkripcijoje. |
| Bet kurios formos WER | Bet kuri iš dviejų sulygiuotų nuorodos formų. |
Šie įverčiai rodo, kaip išmatuotas rezultatas priklauso nuo priimamos rašybos. Bet kurios formos įvertis sumažina baudas už pasirinkimą tarp dviejų nuorodos formų; jis nenustato, kad kiekviena likusi klaida yra vien atpažinimo klaida. Pokyčius aprašome WER reikšmėmis prieš ir po. Skirtumus pateikiame procentiniais punktais: kritimas nuo 40 % iki 30 % yra 10 procentinių punktų sumažėjimas.
Modelius lyginame tais pačiais testo įrašais. 95 % pasikliautinuosius intervalus vertiname pakartotinai perimdami kalbėtojus (10 000 perėmimų) arba atskirus įrašus, kai kalbėtojų tapatybės neprieinamos. Klientų aptarnavimo šnekai perimame ištisus skambučius. Šie intervalai apibūdina testo imties neapibrėžtumą; jie neapima svyravimo tarp mokymo paleidimų ar nuorodų transkripcijų klaidų.
Svyravimą tarp pakartotų mokymo paleidimų pateikiame atskirai. Regioniniai palyginimai apima tik po tris testo kalbėtojus regione ir turėtų būti laikomi žvalgomaisiais. Panašiai palyginimas tarp mokymo ir nematytų kalbėtojų naudoja skirtingus įrašus ir negali atskirti kalbėtojų pažįstamumo nuo įrašų sudėtingumo skirtumų.
Pradinis eksperimento protokolas užfiksuotas po pirmųjų mokymo paleidimų ir prieš jų testo vertinimus. Vienas nepritaikytas modelis jau buvo įvertintas vertinimo grandinei patikrinti. Suvalkijos išskyrimo eksperimentas pridėtas po to, kai buvo peržiūrėti kitų regionų rezultatai, su tais pačiais mokymo nustatymais. Klientų aptarnavimo šnekos vertinimas naudojo jau mokytus modelius. Jo analizė buvo žvalgomoji: planas parašytas po ankstesnio bandomojo vertinimo tais pačiais įrašais.
Po vertinimo viešus skaitomos šnekos testus perkėlėme į antrinius rezultatus, nes jų įverčiai tarp mokymo paleidimų svyravo gerokai. Taip pat neatlikome protokole numatytų papildomų mokymo paleidimų mažiems telefoninės šnekos efektams išspręsti. Todėl telefoninės šnekos palyginimą tarp transkripcijų rašybų paliekame neišspręstą. Planuotas rankinis bendrinės rašybos testo nuorodų redagavimas nebuvo atliktas; visi įverčiai naudoja automatiškai standartizuotą versiją. Visa protokolo istorija ir nuorodų versijos užfiksuotos saugykloje.
Tarminių įrašų pridėjimas pagerina tarmių atpažinimą labiau nei panašaus kiekio kitos spontaninės šnekos pridėjimas. Didelė pagerėjimo dalis gaunama iš pirmųjų papildymų, o transkripcijų rašyba keičia ir išvestį, ir išmatuotą klaidų dažnį. Visi modelių įverčiai pateikti priede šio puslapio pabaigoje.
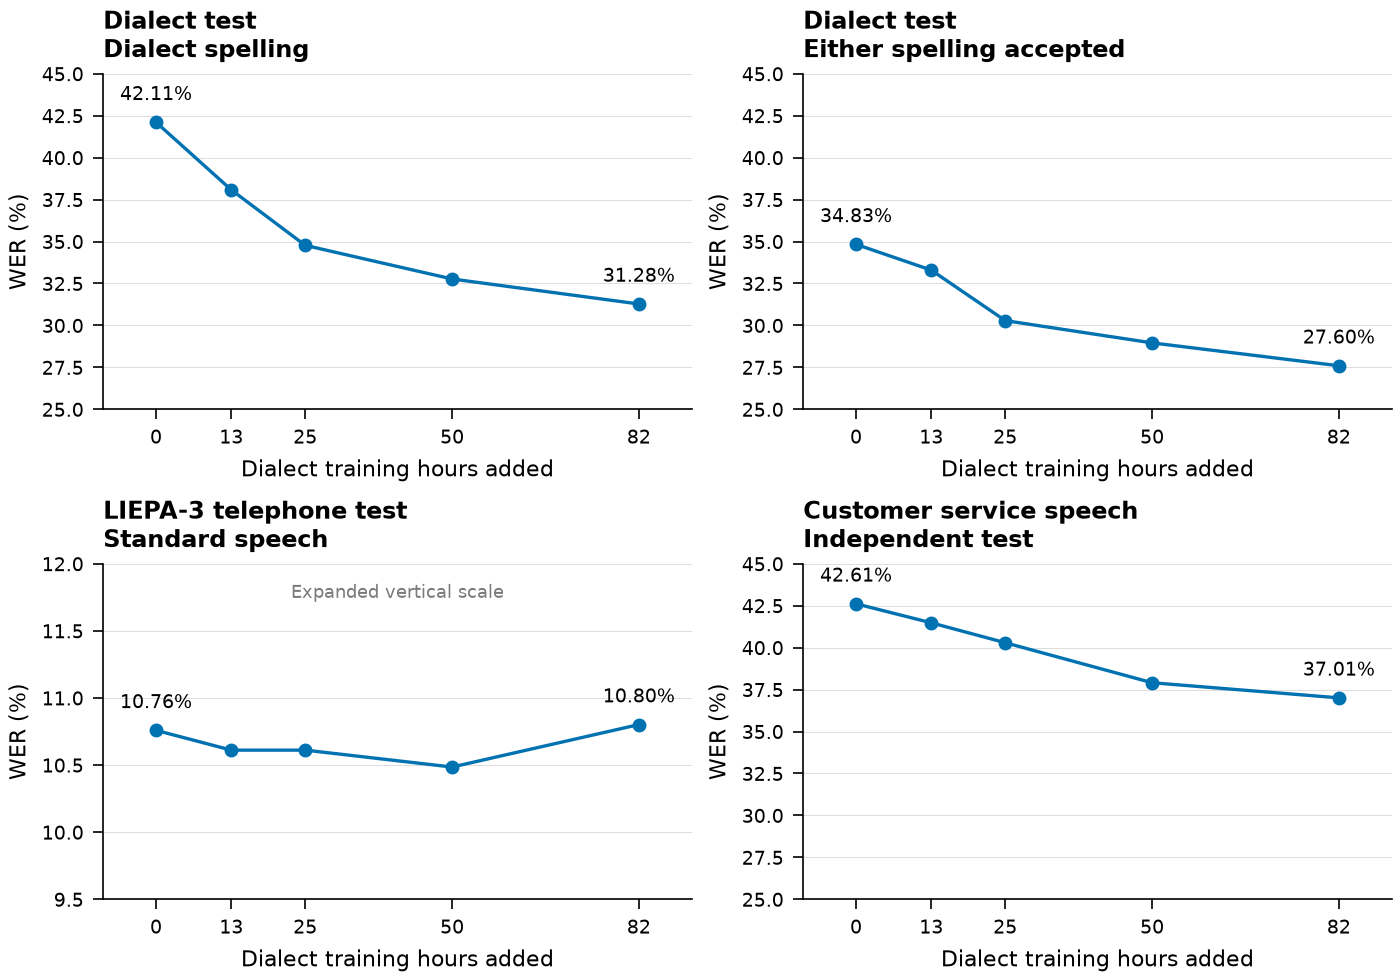
Tikriname, kaip tarmių atpažinimas keičiasi, kai prie bendrinės telefoninės šnekos mokymo duomenų pridedama daugiau tarminių įrašų. Mokome modelius be tarminės šnekos ir su 12,83, 25,43, 50,47, 82,30 papildomų valandų. Šie modeliai naudoja tarminės rašybos mokymo transkripcijas ir identiškus mokymo nustatymus.
Tarmių atpažinimas gerėja kiekviename žingsnyje. Vertinant pagal tarminės rašybos nuorodas, žodžių klaidų dažnis krenta nuo 42,11 % be tarminių mokymo duomenų iki 31,28 % su 82,30 val.. Pirmos 25,43 val. duoda apie du trečdalius šio sumažėjimo. Tolesni papildymai toliau padeda, bet pagerėjimas mažėja. Pagerėjimas matyti ir priimant tarminę arba bendrinę rašybą: žodžių klaidų dažnis krenta nuo 34,83 % iki 27,60 %. Tai rodo, kad nauda neapsiriboja tarminės rašybos atkartojimu.
Klientų aptarnavimo šneka taip pat gerėja pridedant daugiau tarminių įrašų. Tame pačiame vieno paleidimo palyginime WER krenta nuo 42,61 % be tarminių duomenų iki 37,01 % su 82,30 val.. Pagerėjimas tęsiasi per visus išbandytus mokymo kiekius. Tai skiriasi nuo LIEPA-3 telefoninio testo, kur WER keičiasi mažai: nuo 10,76 % iki 10,80 %. Šios telefoninės reikšmės yra žemos, palyginti su originaliais modeliais, ir tikriausiai naudojasi bendrais skambinančiaisiais bei įrašymo sąlygomis tarp telefoninių mokymo ir testo rinkinių. Antras mokymo paleidimas patvirtina bendrą vaizdą: tarminių nuorodų WER krenta nuo 41,13 % iki 31,31 %, o telefoninis WER keičiasi nuo 10,46 % iki 10,72 %.
Suporuoti skirtumai tarp viso tarminio modelio ir tik telefoninio modelio su 95 % intervalais: tarmių testas −10,83 [−14,02, −7,84] pp 1 paleidime ir −9,81 [−12,83, −6,80] pp 2 paleidime; telefoninis testas +0,04 [−0,18, +0,27] pp ir +0,26 [+0,06, +0,47] pp. Šie rezultatai rodo, kad palyginti nedidelė tarminė kolekcija gali duoti esminį pagerėjimą, o papildomi įrašai duoda mažėjančią grąžą. Tačiau kiekvienas didesnis rinkinys apima ir daugiau kalbėtojų, todėl šis eksperimentas neatskiria įrašų valandų poveikio nuo kalbėtojų įvairovės.
| Pridėta tarminės šnekos | Tarmių testo WER: tarminė rašyba | Tarmių testo WER: bet kuri rašyba | LIEPA-3 telefoninis WER | Klientų aptarnavimo šnekos WER |
|---|---|---|---|---|
| Nieko | 42,11 | 34,83 | 10,76 | 42,61 |
| 12,83 val. | 38,08 | 33,30 | 10,61 | 41,48 |
| 25,43 val. | 34,77 | 30,29 | 10,61 | 40,30 |
| 50,47 val. | 32,77 | 28,96 | 10,49 | 37,91 |
| 82,30 val. | 31,28 | 27,60 | 10,80 | 37,01 |
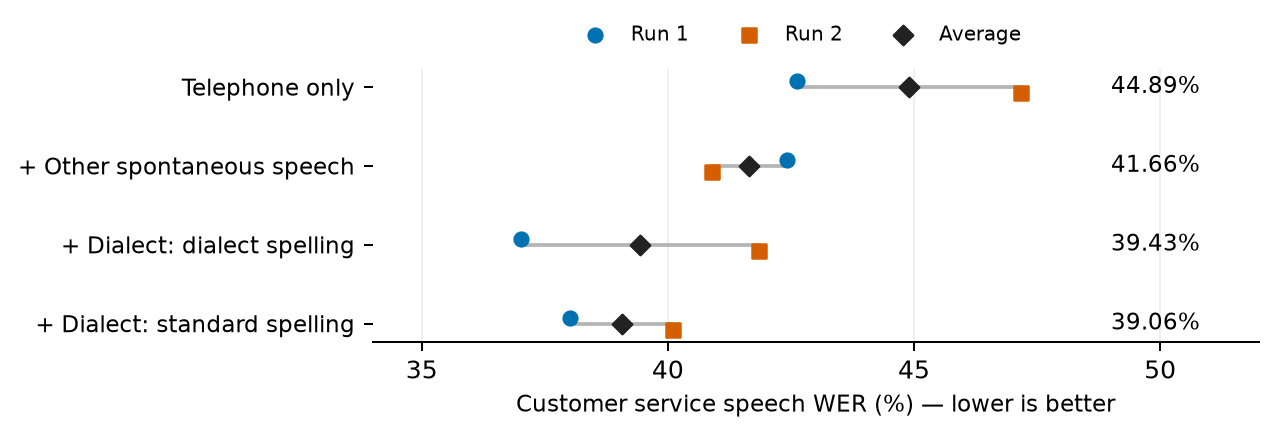
Lyginame du papildymus prie tų pačių bendrinės telefoninės šnekos mokymo duomenų: 82,30 val. tarminės šnekos ir 82,36 val. kitos spontaninės šnekos. Tarminiai įrašai naudoja tarminės rašybos transkripcijas. Šis palyginimas tikrina, ar pagerėjimas atsiranda tiesiog pridėjus daugiau mokymo duomenų.
Abu papildymai pagerina tarmių atpažinimą, bet tarminiai įrašai duoda daug didesnę naudą. Vidurkinant du mokymo paleidimus, WER pagal tarmines nuorodas krenta nuo 41,62 % iki 40,04 % su kita spontanine šneka ir iki 31,30 % su tarmine šneka. Pranašumas išlieka priimant bet kurią rašybą: WER siekia 32,40 % su kita spontanine šneka ir 27,82 % su tarmine šneka. Todėl rezultatas nepriklauso vien nuo tarminės rašybos atitikimo. LIEPA-3 telefoniniame teste kiti spontaniniai įrašai duoda mažesnį WER: 10,34 %, palyginti su 10,76 % pridėjus tarminius įrašus.
Suporuoti skirtumai, tarminė šneka minus kita spontaninė šneka, su 95 % intervalais: tarmių testas −8,62 [−11,52, −5,84] pp (1 paleidimas) ir −8,86 [−12,02, −5,78] pp (2 paleidimas) pagal tarmines nuorodas; −4,58 [−6,75, −2,42] pp ir −4,57 [−7,01, −2,16] pp priimant bet kurią formą; telefoninis testas +0,49 [+0,28, +0,70] pp ir +0,34 [+0,13, +0,55] pp.
Nepriklausomame klientų aptarnavimo šnekos teste vidutinis WER krenta nuo 44,89 % mokant tik telefonine šneka iki 41,66 % su kita spontanine šneka ir 39,43 % su tarmine šneka. Abu tarminio mokymo paleidimai pranoksta atitinkamą tik telefoninį paleidimą: nuo 42,61 % iki 37,01 % ir nuo 47,17 % iki 41,86 %. Perimant skambučius gaunamas 5,46 procentinio punkto sumažėjimas su 95 % intervalu nuo 4,85 iki 6,13, bet šis intervalas atspindi tik testo imtį: du tik telefoniniai paleidimai skiriasi daugiau nei jo plotis, todėl pagrindinis neapibrėžtumas šiame teste yra svyravimas tarp paleidimų, o ne testo imtis. Vidutinis WER mažesnis nei su kita spontanine šneka, bet šis pranašumas pasireiškia tik viename iš dviejų mokymo paleidimų.
Šie rezultatai rodo, kad papildomos šnekos tipas yra svarbus. Šio tyrimo tarmių kalbėtojams atpažinti tarminiai įrašai padeda gerokai labiau nei panašus kiekis kitos spontaninės šnekos.
| Papildoma mokymo šneka | Tarmių WER: tarminė rašyba | Tarmių WER: bet kuri rašyba | LIEPA-3 telefoninis WER | Klientų aptarnavimo šnekos WER |
|---|---|---|---|---|
| Nieko | 41,62 | 34,22 | 10,61 | 44,89 |
| Kita spontaninė šneka | 40,04 | 32,40 | 10,34 | 41,66 |
| Tarminė šneka | 31,30 | 27,82 | 10,76 | 39,43 |
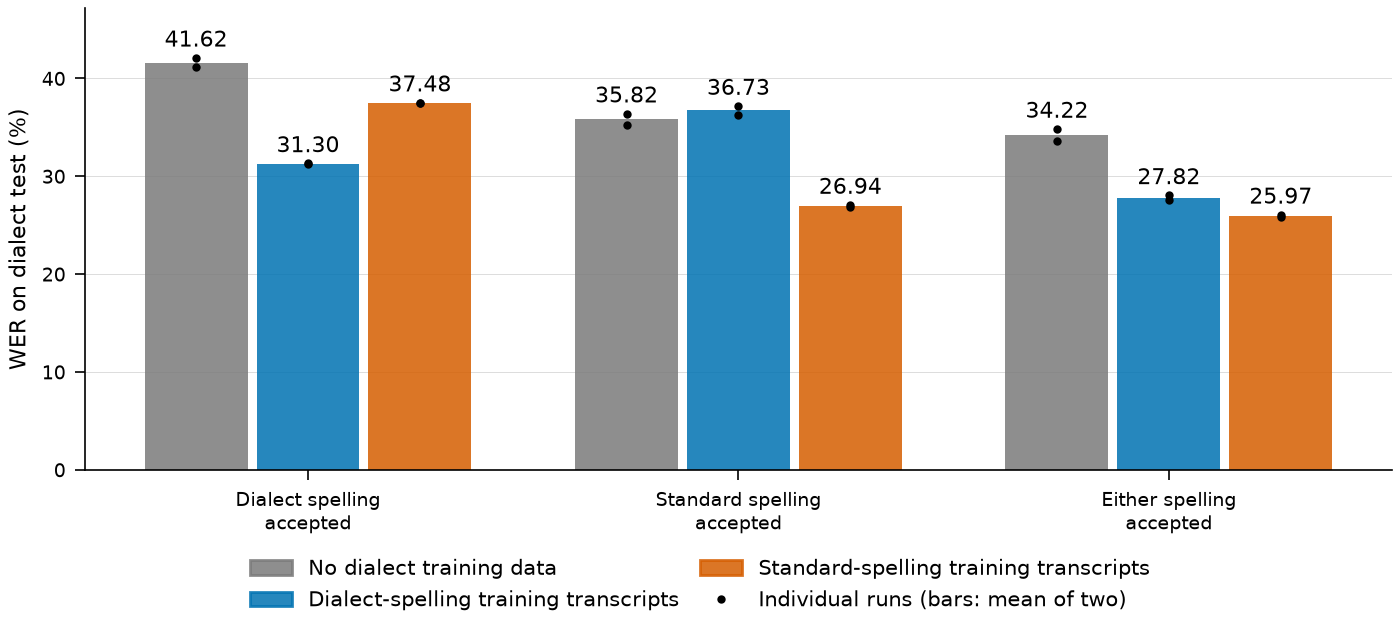
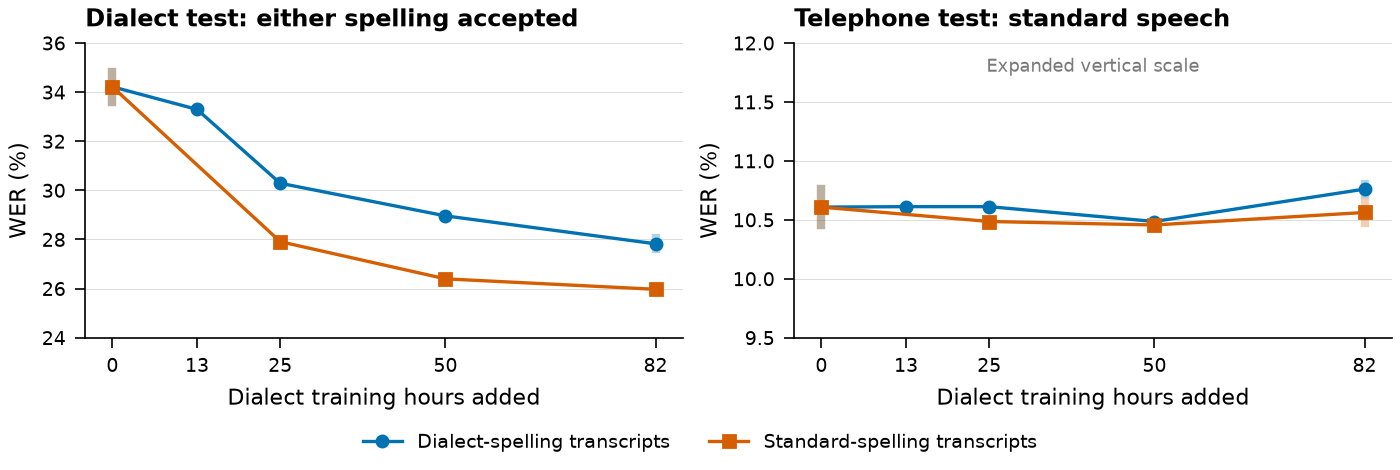
Lyginame dvi mokymo sąlygas, kiekvieną pakartotą du kartus, naudodami tuos pačius bendrinės telefoninės šnekos duomenis ir tas pačias 82,30 val. tarminių įrašų. Skiriasi tik tarminės transkripcijos: viena sąlyga naudoja tarminę rašybą, kita – bendrinę. Abi sąlygas vertiname tais pačiais testo įrašais visais trimis vertinimo būdais.
Nuorodų rašyba stipriai veikia išmatuotą pagerėjimą. Su tarminės rašybos mokymo transkripcijomis WER pagal tarmines nuorodas krenta nuo 41,62 % iki 31,30 %. Tačiau pagal bendrines nuorodas tos pačios mokymo sąlygos WER keičiasi nuo 35,82 % iki 36,73 %. Taigi jos matomas pagerėjimas priklauso nuo to, kurią rašybą testas priima.
Priimant bet kurią rašybą, abu mokymo būdai pranoksta modelį be tarminių duomenų. WER krenta nuo 34,22 % iki 27,82 % su tarminės rašybos transkripcijomis ir iki 25,97 % su bendrinės rašybos transkripcijomis. Bendrinės rašybos transkripcijos duoda mažesnį bet kurios formos WER abiejuose pakartotuose paleidimuose: −1,54 [−2,76, −0,34] pp ir −2,16 [−3,20, −1,06] pp, palyginti su tarmine rašyba, ir −8,78 [−10,38, −7,15] pp bei −7,72 [−9,20, −6,04] pp, palyginti su modeliu be tarminių duomenų.
Taigi tarp modelių, mokytų bendrinės telefoninės šnekos duomenimis, bendrinės rašybos tarminės transkripcijos duoda geriausią bendrą rezultatą vertinant bet kurią formą. Tas pats vaizdas matyti ir su mažesniais mokymo kiekiais – 25,43 val. ir 50,47 val.: bet kurios formos WER 27,91 %, 26,39 % ir 26,06 % su bendrine rašyba vieno paleidimo serijoje. Šis eksperimentas nenustato, kodėl bendrinė rašyba padeda. Viena galimybė – nauda iš dalies stilistinė: bendrinės rašybos mokymo transkripcijos ir bendrinės rašybos testo nuorodos sukurtos ta pačia standartizavimo procedūra, todėl modelis, mokytas tos procedūros išvestimi, pagal ją ir vertinamas. Tarminės rašybos įverčiui ir tik tarminių žodžių klasei, kur bendrinė rašyba veikia blogiau, tai įtakos neturi.
LIEPA-3 telefoniniame teste vidutinis WER yra 10,76 % su tarminės rašybos transkripcijomis ir 10,56 % su bendrinės rašybos transkripcijomis. Kadangi šis skirtumas mažas, palyginti su stebimu svyravimu tarp mokymo paleidimų, šį palyginimą paliekame neišspręstą. Klientų aptarnavimo šnekoje vidutinis WER yra 39,43 % su tarminės rašybos transkripcijomis ir 39,06 % su bendrinės rašybos transkripcijomis. Abi pranoksta mokymą tik telefonine šneka kiekviename pakartotame paleidime, bet mažas skirtumas tarp rašybų neleidžia daryti išvados. Mažiausias stebėtas klientų aptarnavimo WER yra 36,14 % su 50,47 val. tarminės šnekos ir bendrine rašyba. Ta sąlyga turi vieną paleidimą ir nenustato optimalaus mokymo kiekio.
Yra ir kompromisas dėl tik tarminio žodyno. Vieno paleidimo žodžių klasių analizėje klaidų dažnis, priskiriamas žodžiams be bendrinio atitikmens, yra 62,12 % su tarminės rašybos mokymo transkripcijomis ir 73,84 % su bendrinės rašybos transkripcijomis. Šis matas apima papildomus žodžius, vertinant priskirtus tai klasei. Todėl geresnis bendras įvertis nereiškia, kad pagerėja kiekvieno tipo žodžiai.
| Nuorodos žodžių klasė | stock | S | S+X80 | S+D80.dial | S+D80.std | D80.std |
|---|---|---|---|---|---|---|
| Nepakitęs | 63,33 | 27,31 | 24,61 | 22,78 | 20,60 | 17,44 |
| Kitas tarimo pokytis | 85,67 | 64,32 | 61,49 | 45,14 | 45,95 | 37,50 |
| Galūnės pokytis | 82,05 | 57,78 | 55,87 | 39,42 | 38,60 | 30,32 |
| Raidės ą, ę, į, ų | 77,50 | 37,70 | 35,10 | 37,90 | 32,10 | 28,10 |
| Tik tarminis žodis | 96,16 | 76,06 | 72,93 | 62,12 | 73,84 | 69,80 |
Tikriname, ar mokymas kitų regionų tarmine šneka padeda atpažinti regioną, kurio tarminiai įrašai buvo pašalinti iš mokymo. Testas apima visus keturis regionus: Aukštaitiją, Dzūkiją, Suvalkiją ir Žemaitiją. Iš viso jame 12 testo kalbėtojų, po tris iš regiono. Nė vieno iš jų nėra mokymo duomenyse.
Kiekvienam regionui lyginame tris mokymo sąlygas: vien telefoninė šneka; telefoninė šneka ir kitų trijų regionų tarminiai įrašai; telefoninė šneka ir visų keturių regionų tarminiai įrašai. Kiekviena sąlyga naudoja vieną mokymo paleidimą. Tarminės mokymo transkripcijos naudoja bendrinę rašybą, o vertinimas priima tarminę arba bendrinę rašybą. Kiekviename regione visos trys sąlygos vertinamos tais pačiais įrašais.
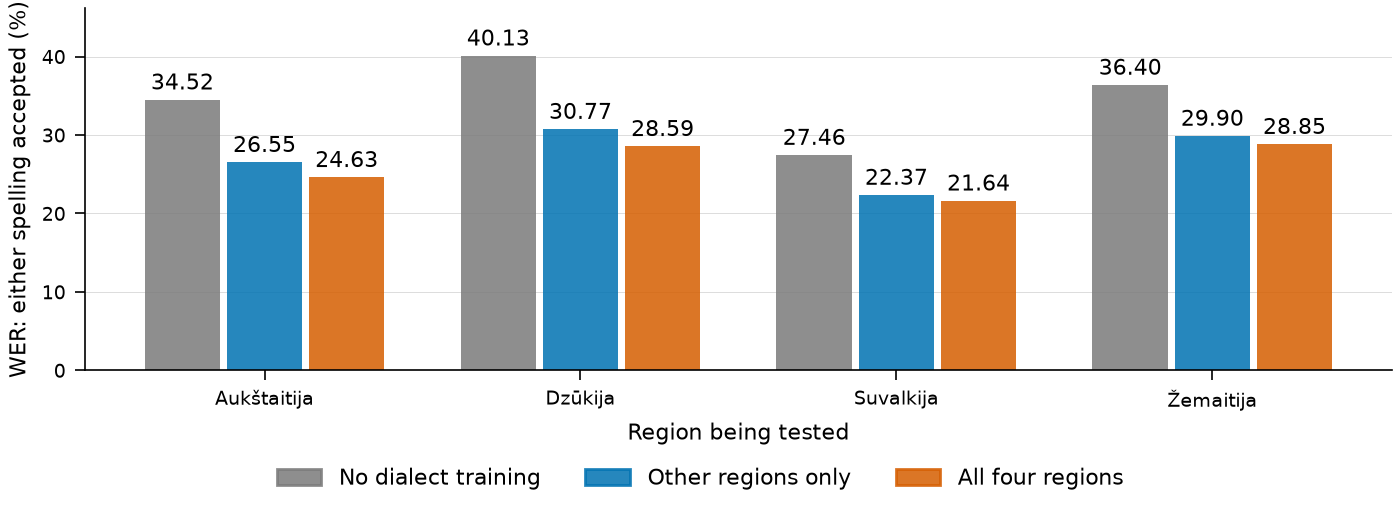
Mokymas kitais trimis regionais sumažina WER kiekviename regione, palyginti su mokymu tik telefonine šneka: nuo 34,52 % iki 26,55 % (Aukštaitija), nuo 40,13 % iki 30,77 % (Dzūkija), nuo 27,46 % iki 22,37 % (Suvalkija), nuo 36,40 % iki 29,90 % (Žemaitija). Tai patvirtina tarminio mokymo naudą net tada, kai testuojamo regiono nėra tarminiuose mokymo duomenyse.
Mokymas visais keturiais regionais duoda mažiausią išmatuotą WER kiekviename palyginime. Tačiau papildomas pagerėjimas Žemaitijai neaiškus: jo 95 % pasikliautinasis intervalas apima nulinį pagerėjimą. Tai žvalgomieji rezultatai, pagrįsti trimis testo kalbėtojais regione ir vienu paleidimu sąlygai. Testuojamo regiono įtraukimas taip pat prideda mokymo valandų, todėl negalime atskirti to regiono šnekos vertės nuo daugiau duomenų naudos.
| Regionas | Valandos | Tik telefoninė | Kiti trys regionai | Visi regionai, 50 val. | Visi regionai, 82 val. | Be regiono − visi regionai | Be regiono − tik telefoninė |
|---|---|---|---|---|---|---|---|
| Aukštaitija | 47,14 | 34,52 | 26,55 | 25,29 | 24,63 | +1,92 [+1,54, +2,12] | −7,97 [−9,44, −4,89] |
| Dzūkija | 68,01 | 40,13 | 30,77 | 28,33 | 28,59 | +2,19 [+1,31, +2,59] | −9,36 [−10,57, −8,13] |
| Suvalkija | 72,97 | 27,46 | 22,37 | 21,69 | 21,64 | +0,73 [+0,49, +1,01] | −5,09 [−8,09, −2,94] |
| Žemaitija | 58,78 | 36,40 | 29,90 | 29,73 | 28,85 | +1,04 [−0,16, +1,74] | −6,50 [−10,88, −4,72] |
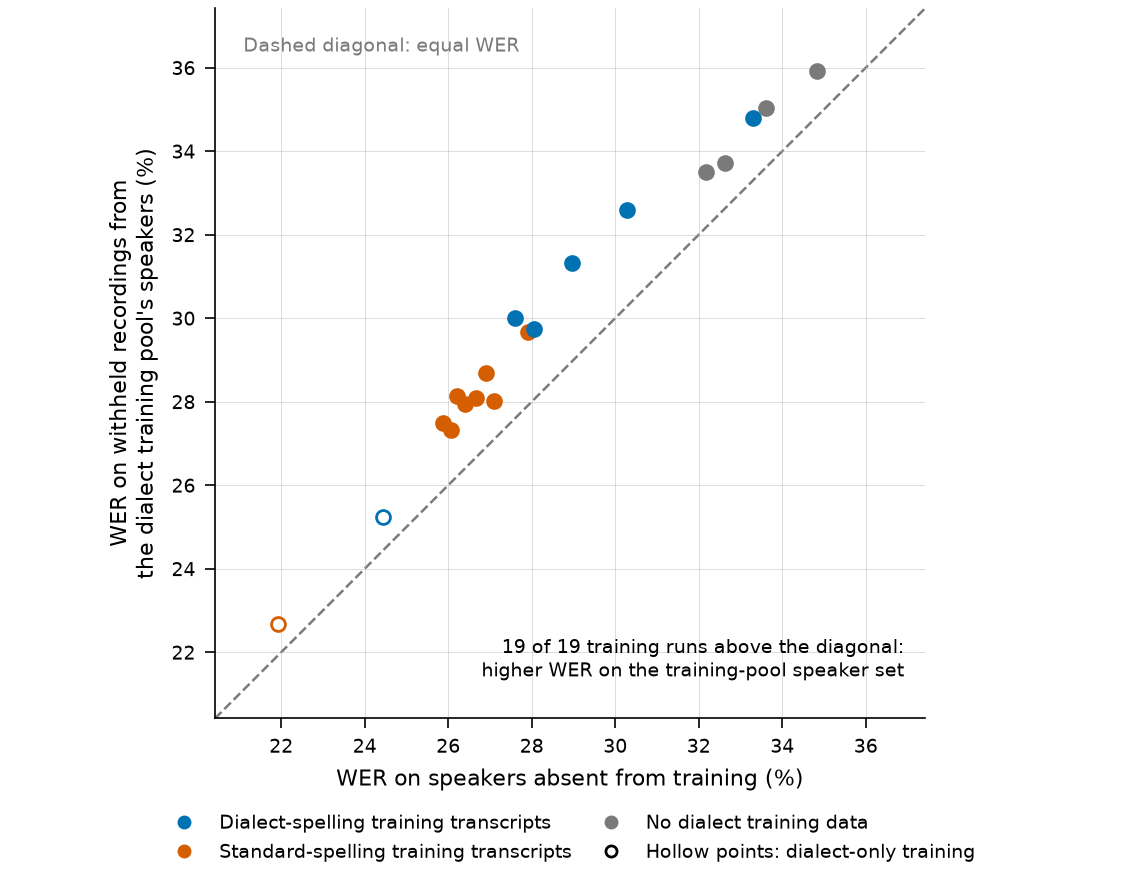
Lyginame du tarminių įrašų rinkinius: atidėtus 12 tarminio mokymo kalbėtojų įrašus ir 12 kalbėtojų, kurių nėra mokyme, įrašus. Nė vienas vertinamas įrašas nebuvo naudotas mokymui. Tikėjomės, kad modeliai, mokyti kitais pirmosios grupės įrašais, tuos kalbėtojus atpažins tiksliau.
Stebimas vaizdas yra priešingas. Visuose 19 mokytuose paleidimuose WER yra didesnis mokymo kalbėtojų įrašams – 0,77–2,41 procentinio punkto. Abu rinkiniai vertinami priimant tarminę arba bendrinę rašybą. Tačiau tas pats vaizdas matyti ir modeliuose, mokytuose be tarminės šnekos, kurie mokymo metu nebuvo susidūrę nė su viena grupe. Modeliai, mokyti mažesniais tarminiais poaibiais arba be vieno regiono, buvo susidūrę tik su dalimi mokymo kalbėtojų. Šie rezultatai rodo, kad palyginimą veikia dviejų įrašų rinkinių sudėtingumo skirtumai.
Todėl negalime daryti išvados, kad kalbėtojų pažįstamumas neduoda naudos. Abu rinkiniai apima skirtingus kalbėtojus ir įrašus, todėl šis eksperimentas jo poveikio neatskiria. Jis rodo tik tai, kad atidėti mokymo kalbėtojų įrašai šiems modeliams buvo sunkesni nei nematytų kalbėtojų įrašai.
Lyginame mokymą vien tarminiais įrašais su mokymu vien bendriniais telefoniniais įrašais arba abiem rinkiniais kartu. „Tik tarminis“ reiškia mokymui naudotus duomenis; visi šie modeliai pradedami nuo to paties pradinio daugiakalbio Parakeet-TDT modelio.
Naudojant vien 82,30 val. tarminės šnekos su bendrinės rašybos transkripcijomis gaunamas mažiausias šiame tyrime stebėtas bet kurios formos tarmių WER: 21,91 %. Tačiau jo telefoninio testo WER yra 19,63 %. Tarminių įrašų derinimas su bendrinės telefoninės šnekos mokymo duomenimis duoda didesnį tarmių WER – 25,97 %, bet daug mažesnį telefoninį WER – 10,56 %. Šio telefoninio skirtumo dydis iš dalies atspindi galimą telefoninio testo kalbėtojų ir kanalo persidengimą; nepriklausomame klientų aptarnavimo teste skirtumas mažesnis. Tik tarminis mokymas su tarminės rašybos transkripcijomis rodo panašų kompromisą: bet kurios formos tarmių WER yra 24,43 %, o telefoninis WER – 28,20 %.
Originalus Parakeet-TDT modelis be mokymo mūsų tyrimo duomenimis pasiekia 68,15 % bet kurios formos tarmių WER ir 42,53 % telefoninį WER; Whisper large-v3 – atitinkamai 53,15 % ir 27,43 %. Parakeet-TDT mokymas vien telefonine šneka pagerina abu įverčius, palyginti su originaliais modeliais, iki 34,22 % ir 10,61 %. Šie rezultatai rodo, kodėl geriausias mokymo pasirinkimas priklauso nuo numatomo naudojimo. Tik tarminis mokymas geriausiai veikia šiame tarmių teste, o jungtinis mokymas palaiko ir tarmių, ir telefoninį atpažinimą. Tik tarminės sąlygos turi po vieną mokymo paleidimą, todėl jų matomą pranašumą reikia patvirtinti pakartotais paleidimais.
| Modelis ir mokymo duomenys | Tarmių WER: bet kuri rašyba | LIEPA-3 telefoninis WER | Klientų aptarnavimo šnekos WER |
|---|---|---|---|
| Originalus Parakeet-TDT, be tyrimo mokymo | 68,15 | 42,53 | 59,51 |
| Originalus Whisper large-v3, be tyrimo mokymo | 53,15 | 27,43 | 54,67 |
| Parakeet-TDT: tik telefoninė šneka | 34,22 | 10,61 | 44,89 |
| Parakeet-TDT: tik tarminė šneka, tarminė rašyba | 24,43 | 28,20 | 51,36 |
| Parakeet-TDT: tik tarminė šneka, bendrinė rašyba | 21,91 | 19,63 | 42,59 |
| Parakeet-TDT: telefoninė + tarminė šneka, bendrinė rašyba | 25,97 | 10,56 | 39,06 |
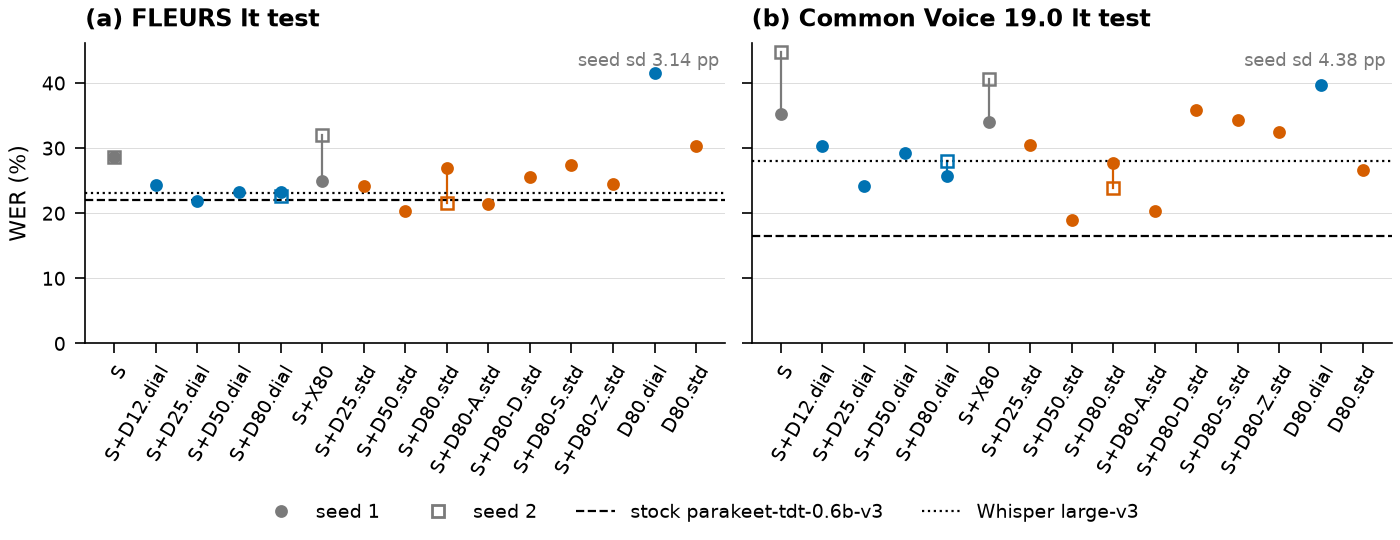
Kiekvieną modelį taip pat vertiname FLEURS ir Common Voice – dviem viešais lietuvių rinkiniais, kuriuose žmonės skaito garsiai. Šie testai tikrina veikimą su kitokio tipo šneka nei spontaniniai telefoniniai pokalbiai, naudoti didžiajai mokymo daliai. Originalus Parakeet-TDT pasiekia 22,10 % WER FLEURS ir 16,52 % Common Voice. Po mokymo vien telefonine šneka du paleidimai pasiekia 28,62 % ir 28,65 % FLEURS bei 35,20 % ir 44,74 % Common Voice.
Viso tarminio rinkinio pridėjimas pagerina abu testus, palyginti su mokymu tik telefonine šneka, abiejuose paleidimuose ir su kiekviena transkripcijų rašyba. Pagerėjimo dydis tarp paleidimų skiriasi. Kiekvienas mokytas modelis Common Voice teste turi didesnį WER nei originalus Parakeet, o FLEURS teste kai kurie pasiekia mažesnį WER. Pavyzdžiui, su bendrinės rašybos tarminėmis transkripcijomis FLEURS WER viename paleidime yra 26,87 %, kitame – 21,51 %. Dėl šio svyravimo mažus skirtumus tarp mokymo sąlygų sunku interpretuoti. Standartinis nuokrypis tarp sėklų keturiose pakartotose sąlygose yra 3,14 pp FLEURS ir 4,38 pp Common Voice, palyginti su 0,36 pp tarmių teste ir 0,13 pp telefoniniame teste.
Skiriasi ir įrašymo sąlygos. Didžioji mokymo šnekos dalis yra telefoninės juostos ir spontaninė, o testuose – plačiajuostė skaitoma šneka. Tarminiai įrašai taip pat plačiajuosčiai, todėl jų pridėjimas keičia ir regionų aprėptį, ir įrašymo sąlygas. Šis eksperimentas nenustato, kurie skirtumai lemia testų elgseną. Todėl šiuos testus laikome antriniais rezultatais.
| Mokymo duomenys | FLEURS WER, 1 / 2 paleidimas | Common Voice WER, 1 / 2 paleidimas |
|---|---|---|
| Nieko: originalus Parakeet-TDT | 22,10 | 16,52 |
| Tik telefoninė šneka | 28,62 / 28,65 | 35,20 / 44,74 |
| Telefoninė + tarminė šneka, tarminė rašyba | 23,24 / 22,58 | 25,77 / 27,99 |
| Telefoninė + tarminė šneka, bendrinė rašyba | 26,87 / 21,51 | 27,75 / 23,85 |
Išvados taikomos šiame tyrime tikrintiems duomenų rinkiniams, modeliui ir mokymo nustatymams. Pradinės protokolo hipotezės ir verdiktai išsaugoti saugykloje.
| Klausimas | Išvada |
|---|---|
| Ar padeda tarminės šnekos pridėjimas? | Taip. Vieno paleidimo serijoje su tarminės rašybos transkripcijomis tarmių ir klientų aptarnavimo šnekos WER krenta su kiekvienu išbandytu papildymu. Vėlesni papildymai tarmių teste duoda mažesnį pagerėjimą. LIEPA-3 telefoninis WER keičiasi mažai. |
| Ar pagerėjimas atsiranda tiesiog pridėjus daugiau duomenų? | Tarminiai įrašai pagerina tarmių atpažinimą gerokai labiau nei panašus kiekis kitos spontaninės šnekos. |
| Kuri transkripcijų rašyba veikia geriau? | Tarp modelių, taip pat mokytų telefonine šneka, bendrinės rašybos tarminės transkripcijos duoda mažiausią WER priimant bet kurią rašybą. Tik tarminis žodynas lieka silpna vieta. |
| Ar nuorodų rašyba veikia rezultatą? | Taip. Tas pats modelis gali rodyti didelį pagerėjimą lyginant su tarminėmis nuorodomis ir jokio pagerėjimo lyginant su bendrinėmis. |
| Ar bendrinė rašyba pagerina LIEPA-3 telefoninės šnekos atpažinimą? | Neišspręsta. Stebimas skirtumas mažas, palyginti su svyravimu tarp mokymo paleidimų. |
| Ar tarminis mokymas padeda neįtrauktam regionui? | Taip visuose keturiuose regioniniuose palyginimuose su 12 testo kalbėtojų. Kiekvienam naudojamas vienas paleidimas sąlygai. Regionų aprėptis ir mokymo valandos susimaišiusios. |
| Ar mokyme atstovaujamus kalbėtojus lengviau atpažinti? | Atidėti tų kalbėtojų įrašai turi didesnį WER. Skirtingi kalbėtojai ir įrašai neleidžia daryti išvados apie pažįstamumo poveikį. |
| Ar galima mokyti vien tarminiais įrašais? | Tai duoda mažiausią tarmių testo WER, bet didesnį telefoninio testo WER nei jungtinis mokymas. Kiekvienas tik tarminio mokymo rezultatas gautas iš vieno paleidimo. |
| Ar tarminis mokymas padeda klientų aptarnavimo šnekai? | Taip šiame nepriklausomame privačiame teste: abi pakartotos tarminio mokymo sąlygos pranoksta mokymą tik telefonine šneka. |
| Ar pagerėjimas persikelia į viešus skaitomos šnekos testus? | Taip, palyginti su mokymu tik telefonine šneka abiejuose pakartotuose paleidimuose, bet ne nuosekliai, palyginti su originaliu Parakeet. |
Pokalbių analitikos sistemoms, tokioms kaip kuriamos Digisensus, šie rezultatai palaiko tarminių įrašų rinkimą kartu su bendrine telefonine šneka. Tarminiai duomenys pagerina regioninių kalbėtojų atpažinimą labiau nei panašus kiekis kitos spontaninės šnekos. Didelė išmatuoto pagerėjimo dalis gaunama iš pirmųjų papildymų, o tai rodo, kad kukli, rūpestingai parinkta tarminė kolekcija gali būti naudinga. Tačiau šis tyrimas kartu didina ir įrašų valandas, ir kalbėtojų įvairovę, todėl nenustato minimalaus valandų ar kalbėtojų skaičiaus.
Nepriklausomi klientų aptarnavimo šnekos rezultatai sustiprina praktinį argumentą: tarminių įrašų pridėjimas pagerina ir anksčiau nematytų klientų aptarnavimo kalbėtojų atpažinimą. Išlikęs regioninis tarimas – vienas galimas paaiškinimas, bet testas nežymi tarminių bruožų ar skambinančiųjų regioninės kilmės. Vien pagerėjimas jo priežasties nenustato.
Transkripcijų rašyba turėtų atspindėti numatomą programos išvestį. Šiame tyrime bendrinės rašybos tarminės transkripcijos duoda mažiausią bet kurios formos klaidą tarp modelių, taip pat mokytų telefonine šneka. Todėl tai perspektyvus pasirinkimas programoms, kurios kuria bendrinės lietuvių kalbos tekstą. Tačiau nauda nėra vienoda: žodžiams be bendrinio atitikmens bendrinės rašybos mokymas vieno paleidimo analizėje padidino klaidų dažnį nuo 62,12 % iki 73,84 %. Programos, kurioms reikia tarminių formų arba kurios priklauso nuo tokių žodžių, turi kitokį reikalavimą ir šią žodžių klasę turėtų vertinti atskirai.
Mokymo duomenų pasirinkimai taip pat reiškia kompromisą tarp šnekos tipų. Tik tarminis mokymas duoda mažiausią klaidą tarmių teste, o tarminių ir telefoninių įrašų derinimas – daug mažesnę klaidą šioje telefoninėje kolekcijoje, kurios testo rinkinyje gali būti tų pačių skambinančiųjų kaip mokyme, ir mažesnę klaidą klientų aptarnavimo šnekoje. Viešuose skaitomos šnekos testuose tarminės šnekos pridėjimas pagerina abu pakartotus paleidimus, palyginti su mokymu tik telefonine šneka, bet nuosekliai nepranoksta originalaus Parakeet. Todėl praktinis modelio pasirinkimas turėtų remtis testo įrašais, reprezentuojančiais numatomą paslaugą.
Vertinant priimama rašyba turėtų būti aiškiai nurodyta. Tos pačios išvesties vertinimas pagal tarmines ir bendrines nuorodas gali duoti skirtingas išvadas apie pagerėjimą. Suporuotos nuorodų transkripcijos ir bet kurios formos vertinimas padeda atskleisti šią priklausomybę. Visų trijų įverčių pateikimas leidžia skaitytojams atskirti tikslumą pagal reikalaujamą išvesties konvenciją nuo tikslumo, kai priimtina bet kuri nuorodos forma.
Išvados skatina panašius eksperimentus kitose kalbose su regionine įvairove, bet nenustato, kad tie patys pagerėjimai pasikartos kitur. Mokymo duomenys yra iš vieno lietuviško tekstyno; tiriame vieną pradinių modelių šeimą ir vieną mokymo procedūrą su papildomu vertinimu privačia klientų aptarnavimo kolekcija. Jos taip pat tiesiogiai nematuoja pagerėjimo esant triukšmui, suspaudimui ar prastam telefono ryšiui.
Transkripcijų tikslumas. Bendrinės rašybos transkripcijos parengtos su kalbos modelio pagalba ir automatiniais patikrinimais. Šių transkripcijų klaidos gali veikti ir mokymą, ir vertinimą. Komandoje nėra profesionalaus dialektologo, o standartizavimo gairės atspindi praktinius sprendimus, kuriuos kiti gali vertinti kitaip. Kadangi mokymo ir testo bendrinės rašybos transkripcijos dalijasi šia procedūra, dalis bendrinės rašybos mokymo pranašumo gali atspindėti atitikimą nuorodoms, o ne geresnį atpažinimą. Parengimo procedūra užfiksuota saugykloje.
Testų aprėptis. Pagrindiniame tarmių teste yra 12 kalbėtojų, tik po tris iš regiono. Todėl regioninės išvados lieka žvalgomosios. LIEPA-3 telefoniniuose mokymo ir testo rinkiniuose gali būti tų pačių kalbėtojų, todėl jų rezultatai nenustato veikimo su visiškai nematytais skambinančiaisiais. Pažįstamų ir nepažįstamų kalbėtojų palyginimas taip pat naudoja skirtingus įrašus ir negali atskirti kalbėtojų pažįstamumo poveikio.
Eksperimento aprėptis. Mokėme vieną pradinių modelių šeimą su fiksuotais mokymo nustatymais ir 10 000 atnaujinimų paleidimui. Skirtingiems rinkiniams geriausiam rezultatui gali reikėti skirtingų mokymo grafikų. Keturios pagrindinės sąlygos turi po du mokymo paleidimus, likusios – po vieną. Daugiau tarminių valandų reiškia ir daugiau kalbėtojų, o regiono pašalinimas sumažina mokymo duomenis. Todėl šie palyginimai jungia kelias galimas įtakas.
Išvadų apimtis. Mažas LIEPA-3 telefoninio testo skirtumas tarp transkripcijų rašybų lieka neišspręstas. Viešų skaitomos šnekos rinkinių rezultatai svyruoja tarp mokymo paleidimų ir skiriasi nuo telefoninių ir tarminių rezultatų. Neatskyrėme įrašymo juostos pločio, kalbėjimo stiliaus, triukšmo ar suspaudimo poveikio. Nepriklausomas klientų aptarnavimo šnekos testas rodo pagerėjimą vienoje privačioje kolekcijoje, bet nenustato tokios pat naudos kitoms klientų grupėms, kalboms ar modeliams. Jo kalbėtojai neturi tarmių žymų, todėl pagerėjimo negalime priskirti būtent regioniniam tarimui.
Tarminių įrašų pridėjimas pagerina lietuvių tarmių atpažinimą labiau nei panašaus kiekio kitos spontaninės šnekos pridėjimas. Nauda siekia ir nepriklausomą klientų aptarnavimo šneką: abu pakartoti paleidimai pranoksta mokymą tik telefonine šneka su kiekviena transkripcijų rašyba. Tai palaiko telefoninių ir tarminių įrašų derinimą pokalbių analitikos programoms.
Bendrinės rašybos tarminės transkripcijos duoda mažiausią bet kurios formos WER tarp modelių, taip pat mokytų telefonine šneka. Tačiau joks mokymo pasirinkimas nėra geriausias kiekviename teste ar žodžių klasėje, o šis tyrimas nenustato optimalaus tarminių duomenų kiekio. Modelį reikėtų rinktis pagal įrašus, reprezentuojančius numatomą paslaugą, aiškiai nurodant priimamą transkripcijų rašybą.
Viskas, ką tyrimas paskelbė, pateikta čia su nuoroda, versijos žyma ir licencija. Vieša analizė atkuria pateiktus rezultatus ir lenteles iš paskelbtų vertinimo įrašų. Klientų aptarnavimo šnekos garsas, transkripcijos ir modelių išvestys lieka privačios; pateikiami tik apibendrinti rezultatai. Kitus kontrolinius taškus galima gauti paprašius adresu saulius@digisensus.com.
Galutinė ataskaita, 20 puslapių, su visomis lentelėmis, diagramomis ir visų rezultatų priedu.
/assets/research/lithuanian-dialect-asr-study-2026-10-05.pdfTyrimo kodas, mokymo receptai, užfiksuoti padalijimai, paleidimų registras, iš anksto užregistruotas protokolas ir analizės skriptai, atkuriantys kiekvieną ataskaitos skaičių.
github.com/Digisensus/lithuanian-dialect-asr · v1.0Tarminė šneka su kalbėtojų nepersidengiančiais padalijimais, keturiais mokymo poaibiais ir bendrinės rašybos transkripcijų sluoksniu su žodžių sulygiavimu ir pokyčių žymomis.
huggingface.co/datasets/Digisensus/lithuanian-dialect-speech-liepa-3-100h-punctuated · v2.0Telefoninė šneka su tyrimo padalijimų sąrašais.
huggingface.co/datasets/Digisensus/lithuanian-phone-speech-liepa-3-429h-punctuated · v2.0Viešų testų vertinimo įrašai: nuorodos, visų 21 vertintų sistemų hipotezės, rezultatai ir kontrolinė imtis.
huggingface.co/datasets/Digisensus/lithuanian-dialect-asr-eval · v1.0Tik telefoninė šneka. Sąlygos 1 paleidimas, NeMo kontrolinis taškas su mokymo konfigūracija.
huggingface.co/Digisensus/parakeet-tdt-0.6b-lt-study-s · v1.0Telefoninė + tarminė šneka, tarminė rašyba. Sąlygos 1 paleidimas, NeMo kontrolinis taškas su mokymo konfigūracija.
huggingface.co/Digisensus/parakeet-tdt-0.6b-lt-study-s-d80-dial · v1.0Telefoninė + tarminė šneka, bendrinė rašyba. Sąlygos 1 paleidimas, NeMo kontrolinis taškas su mokymo konfigūracija.
huggingface.co/Digisensus/parakeet-tdt-0.6b-lt-study-s-d80-std · v1.0Telefoninė + kita spontaninė šneka (kontrolė). Sąlygos 1 paleidimas, NeMo kontrolinis taškas su mokymo konfigūracija.
huggingface.co/Digisensus/parakeet-tdt-0.6b-lt-study-s-x80 · v1.0Tik tarminė šneka, tarminė rašyba. Sąlygos 1 paleidimas, NeMo kontrolinis taškas su mokymo konfigūracija.
huggingface.co/Digisensus/parakeet-tdt-0.6b-lt-study-d80-dial · v1.0Tik tarminė šneka, bendrinė rašyba. Sąlygos 1 paleidimas, NeMo kontrolinis taškas su mokymo konfigūracija.
huggingface.co/Digisensus/parakeet-tdt-0.6b-lt-study-d80-std · v1.0| Modelis | Mokymo duomenys | Tarminė nuor. | Bendrinė nuor. | Bet kuri | Telefoninė |
|---|---|---|---|---|---|
| parakeet-tdt-0.6b-lt-study-s | Tik telefoninė | 42,11 | 36,40 | 34,83 | 10,76 |
| parakeet-tdt-0.6b-lt-study-s-d80-dial | Telefoninė + tarminė, tarminė rašyba | 31,28 | 36,29 | 27,60 | 10,80 |
| parakeet-tdt-0.6b-lt-study-s-d80-std | Telefoninė + tarminė, bendrinė rašyba | 37,52 | 27,06 | 26,06 | 10,65 |
| parakeet-tdt-0.6b-lt-study-s-x80 | Telefoninė + kita spontaninė (kontrolė) | 39,90 | 33,86 | 32,18 | 10,31 |
| parakeet-tdt-0.6b-lt-study-d80-dial | Tik tarminė, tarminė rašyba | 27,18 | 35,32 | 24,43 | 28,20 |
| parakeet-tdt-0.6b-lt-study-d80-std | Tik tarminė, bendrinė rašyba | 35,15 | 22,72 | 21,91 | 19,63 |
Cituoti šį tyrimą: Jarašiūnas, S. (2026). Lithuanian speech recognition: effects of dialect training and transcript spelling. Digisensus, Vilnius. https://digisensus.com/lithuanian-dialect-speech-recognition/
WER (%) kiekvienam vertintam modeliui kiekviename testo rinkinyje; mažiau yra geriau. Eilutės su ² – dviejų mokymo paleidimų vidurkiai. Trys tarmių testo stulpeliai priima tarminę, bendrinę arba bet kurią rašybą. „Mokymo kalbėtojai“ – atidėti tarminio mokymo kalbėtojų įrašai, vertinti priimant bet kurią formą; kalbėtojų matymas priklauso nuo mokymo poaibio. Modelių pavadinimai: S = 420,17 val. telefoninės šnekos; D12…D80 = tarminė šneka pagal valandas; X80 = kita spontaninė šneka; .dial / .std = transkripcijų rašyba; -A, -D, -S, -Z = pašalintas regionas.
| Modelis | Tarmių testas: tarminė nuor. | Tarmių testas: bendrinė nuor. | Tarmių testas: bet kuri | Mokymo kalbėtojai: bet kuri | Telefoninė | FLEURS | Common Voice |
|---|---|---|---|---|---|---|---|
| Originalūs modeliai, be tyrimo mokymo | |||||||
| parakeet-tdt-0.6b-v3 (stock) | 71,67 | 69,09 | 68,15 | 69,10 | 42,53 | 22,10 | 16,52 |
| Whisper large-v3 | 59,36 | 54,57 | 53,15 | 51,77 | 27,43 | 23,17 | 28,09 |
| Tarminės rašybos transkripcijos, pagal valandas | |||||||
| S² | 41,62 | 35,82 | 34,22 | 35,48 | 10,61 | 28,64 | 39,97 |
| S+D12.dial | 38,08 | 38,88 | 33,30 | 34,79 | 10,61 | 24,32 | 30,35 |
| S+D25.dial | 34,77 | 37,29 | 30,29 | 32,59 | 10,61 | 21,89 | 24,24 |
| S+D50.dial | 32,77 | 37,09 | 28,96 | 31,32 | 10,49 | 23,22 | 29,32 |
| S+D80.dial² | 31,30 | 36,73 | 27,82 | 29,88 | 10,76 | 22,91 | 26,88 |
| Kontrolė: kita spontaninė šneka | |||||||
| S+X80² | 40,04 | 34,10 | 32,40 | 33,61 | 10,34 | 28,48 | 37,34 |
| Bendrinės rašybos transkripcijos | |||||||
| S+D25.std | 38,31 | 29,14 | 27,91 | 29,67 | 10,49 | 24,22 | 30,50 |
| S+D50.std | 37,67 | 27,47 | 26,39 | 27,94 | 10,46 | 20,35 | 18,99 |
| S+D80.std² | 37,48 | 26,94 | 25,97 | 27,40 | 10,56 | 24,19 | 25,80 |
| Tik tarminiai duomenys | |||||||
| D80.dial | 27,18 | 35,32 | 24,43 | 25,24 | 28,20 | 41,54 | 39,74 |
| D80.std | 35,15 | 22,72 | 21,91 | 22,68 | 19,63 | 30,34 | 26,71 |
| Be vieno regiono | |||||||
| S+D80-A.std | 38,00 | 27,95 | 26,92 | 28,69 | 10,53 | 21,38 | 20,33 |
| S+D80-D.std | 38,19 | 28,10 | 27,09 | 28,01 | 10,58 | 25,64 | 35,81 |
| S+D80-S.std | 38,13 | 27,58 | 26,67 | 28,09 | 10,61 | 27,37 | 34,35 |
| S+D80-Z.std | 37,44 | 27,37 | 26,20 | 28,14 | 10,64 | 24,43 | 32,43 |
Vertintuvas: score.py 1.3 (2026-10-04), 10 000 bootstrap perėmimų. Iš viso įvertinta 21 sistemų.
PDF, 20 psl., 2026 m. spalio 5 d.. Klausimai: saulius@digisensus.com